JJ1GUJのブログ

@[email protected]

0 following9 followers

Hugo+Holloの組み合わせによるFediverse連携を行っているブログです。 自宅鯖で動かしています。

https://blog.jj1guj.net/posts/try_knowledge_distillation_on_shogi_ai/

将棋AIで知識蒸留を試す

https://blog.jj1guj.net/posts/try_weight_space_programming_on_shogi_ai/ の続編

はじめに

前回将棋AIでWeight-Space Programmingを試したところうまくいかなかったので知識蒸留を行い、通常学習モデルと比べどのくらい強くなるのかを試してみた。 また、知識蒸留モデルと通常学習モデルでネットワークの重みにどのような違いが出るのか気になったため、LLMにネットワークの重みを読み込ませ、どのような違いがあるのか解析させた。

知識蒸留とは

知識蒸留はGeoffrey Hintonらによって導入された機械学習手法である1。 大規模モデルの出力や内部表現を小規模モデルに教えることで、小規模モデルを一から学習させるよりも効率よく、高い精度で学習できる手法である。 将棋AIでも主にDL系モデルからNNUE系モデルへの知識蒸留が盛んに使われており、2026年に開催された世界コンピュータ将棋選手権での独創賞・CSA貢献賞が知識蒸留であったことも記憶に新しい2。

学習実験

モデルの生成を兼ねて学習実験を行い、policy・valueのaccuracy(正解率)の比較を行った。

学習データにはDL将棋本付属のデータを使用した。 知識蒸留時のみpolicyとvalueを大規模モデルであるponkotsu第36回世界コンピュータ将棋選手権バージョン(ResNet35x512)の出力に置き換えた。 このモデルは以下で配布している。

https://jj1guj.booth.pm/items/8321632

学習条件

項目 通常学習の設定値 知識蒸留の設定値
epoch数 144 同左
最適化関数 SGD 同左
スケジューラ ReduceLROnPlateau(eps=1e-20, factor=0.5) 同左
初期学習率 0.2 同左
最終学習率 7.8125e-04 1.5625e-03
AMP dtype float16 同左

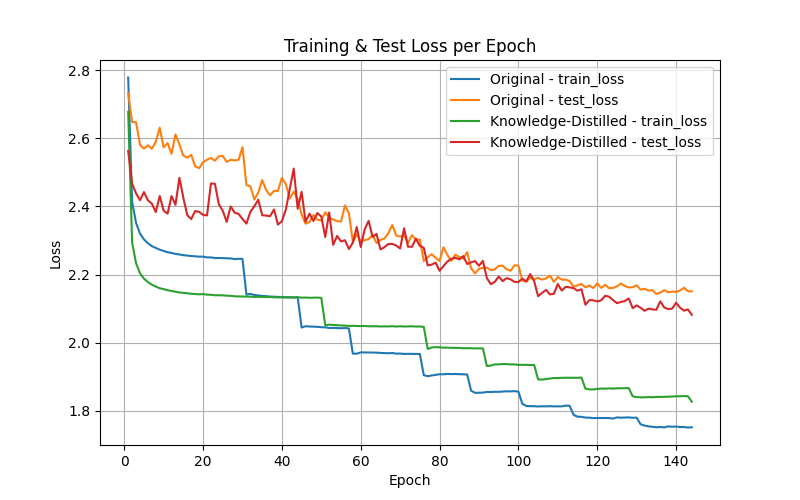
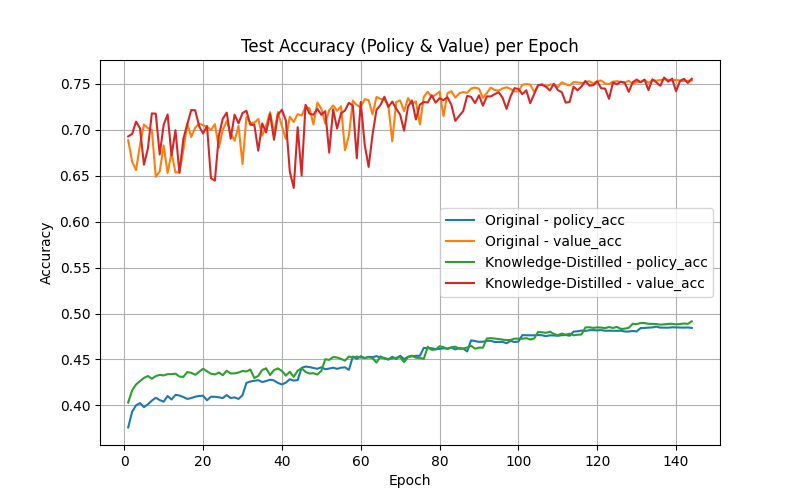
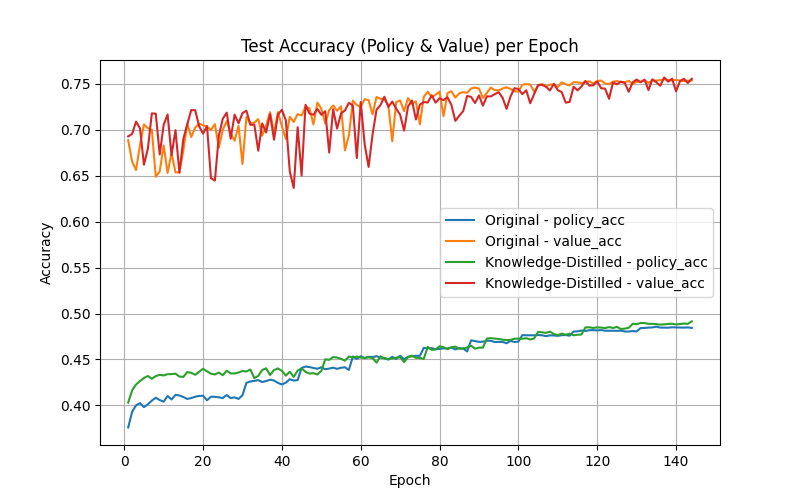
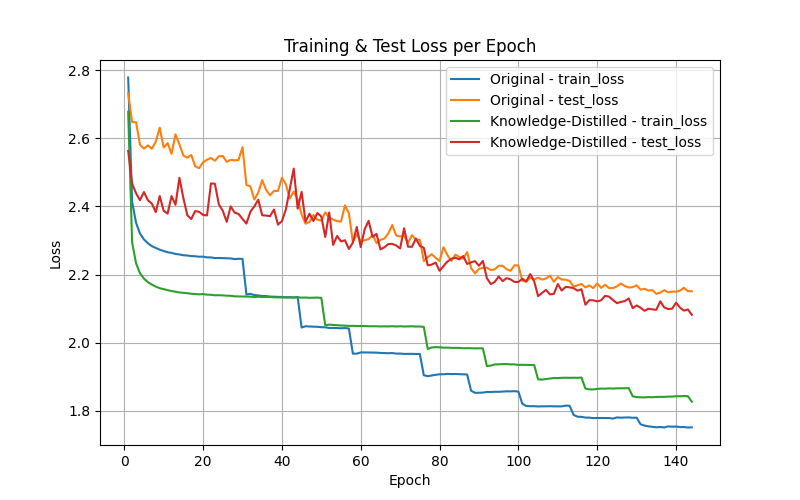
学習曲線及びaccuracyの推移を以下の図に示す。

学習曲線

学習曲線

policy・valueのaccuracyの推移

policy・valueのaccuracyの推移

DL将棋本付属のテストデータに対するpolicy・valueのaccuracyを以下の表に示す。

テストデータに対するaccuracy

手法 Policy Accuracy (%) Value Accuracy (%)
通常学習 48.8 75.7
知識蒸留 49.5 76.1

以上のように知識蒸留モデルの方が最終学習率が高いにもかかわらずtest lossは低く、accuracyは高くなった。 これは教師ラベルを大規模モデルの出力に置き換えたことで、その表現力が高まったためと考えられる。 元の学習データのpolicyは指した手のみ1、指した手以外の手は0というようなone-hot表現となっている。 しかし知識蒸留時の教師ラベルには、指した手以外の手にも着手確率が記録されているため、実際に指されていない手同士でどちらの方がより着手確率が高いかが知識として与えられるようになっている。 これは、valueについても同じことが言える。 元の学習データのvalueは与えられた局面において手前側のプレイヤーが勝ったら1、負けたら0という二値ラベルになっている。 これが知識蒸留時には手前側のプレイヤー視点の勝率となるため同じ勝ちの局面でもどちらの方がより勝ちに近いかが知識として与えられるようになっている。

対局実験

知識蒸留モデルと通常学習モデルで強さに差があるか確認するための対局実験を行った。

思考エンジンにはやねうら王(YANEURAOU_ENGINE_DEEP_TENSOR_RT_UBUNTU)を使用し、探索パラメータはデフォルト値を使用した。 やねうら王互角局面集2025を初期局面とし、1分2秒フィッシャーで200局対局した結果を以下に示す。 なお勝率において引き分けは0.5勝0.5敗として計算している。

知識蒸留モデルの勝敗

勝敗 勝率(%)
135勝44敗21分 72.8

レート差は170.6±50.9(95%信頼区間)となり、知識蒸留により有意に強くなることがわかった。 ちなみに先手勝率は71.5%(66勝23敗11分)、後手勝率は74.0%(69勝21敗10分)だった。

LLMによる解析

ここではGitHub Copilotで使用するLLMをClaude Opus5.5に固定して解析を行った。

ネットワークの重みはONNX形式で渡した。 ただしGitHub CopilotのClaude Opus5.5だとONNXファイルを直接読み込むことができなかったため、プロンプトでONNXファイルのパスを与え、Python経由で読み込ませた。 機械学習ライブラリやcshogiなどのツール及び学習データ・棋譜はモデルの学習以外の用途に限って使用を認めた。

LLMはブロックを1つずつ外して推論し出力の変化を見る実験と、ネットワークの重みの読み取りの2つの方法で解析していた。 なお、あくまでLLMによる解析であり検証した結果ではないため本当に正しいかは不明である。

ResNetブロック

通常学習モデルにおける各ブロックの役割は以下の通りだった。

通常学習モデルにおける各ブロックの役割

ブロック 役割 Policyへの貢献度 Valueへの貢献度
1 自玉の位置と利きを整理し、歩打ちなどの駒打ちの候補手を作る 中 中
2 利きの情報を整理し、歩打ちなどの駒打ちの候補手を補う 小 中
3 両玉の位置をもとに、銀打ちなどの駒打ちの候補手を作る 小 中
4 両玉の周りの駒と利きの関係を作る 小 中
5 敵の利きと両玉の位置をもとに、桂打ち・銀打ち・角打ちの候補手を作る 小 中
6 駒打ちの候補手を作る 小 中
7 敵玉の周りの利きを広げ、駒打ちの候補手を作る 小 小
8 敵玉を攻める駒打ちの候補手を作る 小 小
9 最終手前の調整として銀打ちの候補手を作る 中 中
10 最終組み立てとして、盤上の駒の移動(特に前に進む手)を作り、valueの大部分も作る 大 大

各ブロックごとのpolicyにおける大まかな役割は知識蒸留モデルでも変わらなかった。 ただし以下の3点が異なっていた。

  • valueをブロック10に加え入力に近いブロック1・2と出力に近いブロック9で分担するようになった
    • 通常学習モデルではブロック10のみ貢献度が「大」だった
    • 知識蒸留モデルではブロック1・2・9も「大」だった
  • ブロック1で読む利きが変化した
    • 通常学習モデルでは敵の大駒の利きを中心に読んでいた
    • 知識蒸留モデルでは自玉と敵玉の利きを中心に読むようになった
  • 歩打ちの候補手を作るブロックが変化した
    • 通常学習モデルではブロック1・6に集中しブロック2で補っていた
    • 知識蒸留モデルではブロック2〜5に分散していた

また、最後のResNetブロック(ブロック10)の出力(9×9×154)には、通常学習モデルと知識蒸留モデルで以下の違いが見られた。

  • policyの組み立てに使うチャンネルが入れ替わり、主要なチャンネルが増えた
    • policyに大きく効くチャンネル数が3から7に増えた
  • 入玉と敵陣の制圧に反応するチャンネルができた
    • policyとvalueの両方に効いていた
  • valueの判断材料が分散した
    • 通常学習モデルでは、自分の利きが敵より多いかを表すチャンネルにvalueのほとんどを任せていた
    • 知識蒸留モデルでは、このチャンネルへの依存が半分以下になり、以下のチャンネルの比重が増えた
      • 不利な要素を表すチャンネル(自玉が攻められているか、駒損しているか)
      • 局面の進み具合を表すチャンネル

policy head・value head

policy headには大きな違いが見られなかった。 一方でvalue headには以下の違いが見られた。

  • 隠れ層で実質的に使われていないユニットが増えた
    • 重みがすべてほぼ0になっているユニット数が3から50に増えた
      • 実際これらのユニットを取り除いて隠れ層のユニット数を154から104にしても、出力は浮動小数点の誤差の範囲でしか変わらなかった
    • 残りのユニットはより多くの局面で働くようになった

まとめ

今回は知識蒸留を行いaccuracy・対局での強さ・ネットワークの重みの構造にどのような差が出るかを検証した。 その結果、知識蒸留モデルはテストデータに対するpolicy・valueのaccuracyがいずれも通常学習モデルを上回り、対局実験でも勝率72.8%(レート差170.6±50.9)と有意に強くなった。 これは、one-hot表現や二値ラベルだった教師ラベルを大規模モデルの出力に置き換えたことで、指されていない手同士の優劣や、同じ勝ちの局面の中での勝ちやすさの差も学習できるようになったためと考えられる。

また、LLMによる解析では、policyに関する各ブロックの大まかな役割やpolicy headの構造に大きな違いは見られなかった。 一方でvalueについては、1つのブロックやチャンネルに頼る形から、複数のブロックやチャンネルで分担して判断する形へ変わっていた。 さらにvalue headでは実質的に使われないユニットが増えており、value headを小さくしても同等の出力が得られる可能性がある。 ただし、これらはLLMによる解析結果であり、正しさは検証していない点に注意が必要である。

  1. https://arxiv.org/abs/1503.02531 ↩︎

  2. https://x.com/nodchip/status/2051677405203636245 ↩︎

学習曲線
ALT text

学習曲線

policy・valueのaccuracyの推移
ALT text

policy・valueのaccuracyの推移
  • 入玉ゲートの書き換え
    • 入玉局面で駒の損得に過剰反応するvalue_fc1の24ユニットにおいて、入玉の目印(マップ24の敵陣1〜3段、マップ21の自陣7〜9段)の重みを0.02減らした
      • 入玉局面での駒の損得への過剰反応を抑える狙い
  • バイアス補正
    • 悲観的な評価(−0.11)を打ち消すため、value_fc2.biasを +0.1 にした
  • 評価値の補正
    • value_fc2 の重みとバイアスを1.2倍にして、中程度の評価値を広げた
    • 使われていなかった隠れユニット146・42で、大差の局面における評価値の伸びを抑える折れ線を作った

この書き換えを行い、書き換え前とResNet35x512に対するvalue・loss及びテストデータに対するaccuracyの計測を行った。 テストデータにはDL将棋本付属のテストデータを使用した。(floodgate_test_2017-2018_r3500_eval5000.hcpe)

ResNet35x512に対する計測結果

モデル policy loss value loss(logit の L1) policy accuracy
元のモデル(resnet10x154-144) 1.4436 0.6178 69.37%
書き換え後モデル 1.4436 0.5787 69.37%

テストデータに対する計測結果

モデル policy accuracy value accuracy
元のモデル(resnet10x154-144) 0.4883 0.7567
書き換え後モデル 0.4883 0.7546
ResNet35x512(参考) 0.5469 0.7840

ResNet35x512に対するvalueのlossを低くし、評価値のスケールを近づけることはできたがpolicyの分布を近づけることができなかった。 また、テストデータに対するvalue accuracyは書き換え前に比べてわずかに悪化した。

対局実験

パラメータ書き換え前と書き換え後でどれくらい強くなったか計測するための対局実験を行った。

思考エンジンにはやねうら王(YANEURAOU_ENGINE_DEEP_TENSOR_RT_UBUNTU)を使用し、探索パラメータはデフォルト値を使用した。 やねうら王互角局面集2025を初期局面とし、1分2秒フィッシャーで200局対局した結果を以下に示す。 なお勝率において引き分けは0.5勝0.5敗として計算している。

パラメータ書き換え前と書き換え後の対局結果

書き換え後モデルの勝敗 書き換え後モデルの勝率(%)
77勝91敗32分 46.5

レート差は-24.4±44.4となり、有意差はなくネットワークパラメータ書き換えの効果はなかった。

対局実験の棋譜解析

対局実験の棋譜解析を行い、パラメータ書き換え後モデルの敗因を分析した。 その結果を以下に示す。

入玉の有無ごとの勝敗・勝率内訳

局の種類 局数 書き換え後モデルの勝敗 書き換え後モデルの勝率(%)
入玉なし 138 48勝60敗30分 45.7
書き換え後モデルだけ入玉 13 10勝3敗0分 76.9
元のモデルだけ入玉 16 9勝6敗1分 59.4
相入玉 33 10勝22敗1分 31.8
  • 宣言勝ち: 元のモデル 17局、書き換え後モデル 6局
  • 相入玉: うち19局は両方入玉した時点で点数負けしていた

この表から相入玉の将棋の勝率が著しく低く、正確に局面を評価できていないことがわかった。 これは入玉ゲートを書き換えた影響であると考えられる。 入玉局面の駒の損得に対する過剰反応はあくまでResNet35x512と比べたときの話であり、実際にはこれによって入玉将棋の点数勝負で有利に働いていたようだ。

対局実験の棋譜解析を踏まえたパラメータの書き換え

相入玉の勝率が著しく低くなったことを踏まえ、再度パラメータの書き換えを行った。 書き換え内容は以下の通り。

  • これまでの書き換え内容の破棄
  • ブロック7の中間ch104 の残差チャンネルへの書き込み要素をすべて0に
    • 相手の利きや自玉・相手玉の利きが少ないマスで働き、成る手を抑制しないように

2回目の書き換え後のDL将棋本付属のテストデータに対する計測結果は以下の通り。

テストデータに対する計測結果

モデル policy accuracy value accuracy
元のモデル(resnet10x154-144) 0.4883 0.7567
書き換え後のモデル 0.4883 0.7546
2回目の書き換え後のモデル 0.4882 0.7569
ResNet35x512(参考) 0.5469 0.7840

元のモデルに対し誤差の範囲内でしか精度が向上しておらず、ネットワークパラメータ書き換えの効果が薄いと判断したため、対局実験は行わずここで打ち切った。

まとめ

Weight-Space Programmingの記事を参考に将棋AIのモデルで知識蒸留・改善ができないかを検証した。 その結果、モデル内のどのブロックのどのチャンネルでどのような役割を担っているかを解析することはできたが、ネットワークパラメータの書き換えにより元のモデルより強くすることはできなかった。

今回参考にした記事がミスリーディングをしているという記事もあり、効果は限定的であると考えられる。

https://honnibal.dev/blog/astra-read-write-misleading

今後は実際に知識蒸留を試し、知識蒸留を行ったモデルと行っていないモデルでどのような差があるかLLMに解析させてみる予定である。

honnibal.dev

The 'Astra can read and write weights to improve Qwen' post is misleading · honnibal.dev

The experiments that read raw weights and the ones that fix Qwen use completely different techniques.

https://blog.jj1guj.net/posts/try_weight_space_programming_on_shogi_ai/

将棋AIでWeight-Space Programmingを試す

はじめに

https://rikiyat.github.io/blog/weight-space-programming/ でLLMにネットワークの重みを直接書き換えさせるのが話題になっていたので試してみた。

今回はWCSC36で使用したResNet36x512のモデルからResNet10x154への蒸留と強化を試してみた。 来年のWCSC37ではハードウェアの都合上大きなモデルを搭載できないため、知識蒸留等を行って小さいモデルで精度を上げる必要があるが、これがうまくいけばほとんど学習をさせずにモデルの精度を上げられるとの目論見がある。

実験条件

今回はGitHub CopilotでモデルをClaude Opus5.5をに設定して実験を行った。

ネットワークの重みはONNX形式で渡した。 ただしGitHub CopilotのClaude Opus5.5だとONNXファイルを直接読み込むことができなかったため、プロンプトでONNXファイルのパスを与えて読み込ませた。

機械学習ライブラリやcshogiなどのツール及び学習データ・棋譜の使用は学習用途以外での使用のみ認めた。

また、プロンプトで以下のリンクを渡し、この手法に則ってパラメータを編集するように指示した。

https://rikiyat.github.io/blog/weight-space-programming/

モデルの解析

手始めにResNet35x512とResNet10x154のモデルの解析をさせ、どのブロック・チャンネルでそれぞれどのような役割を担っているか解析させてみた。 それらしい解析結果が出てきたが検証のしようがないため正しいかどうかは不明である。

ResNet35x512

LLMの解析結果をそのまま貼る。

ResNet35x512 の解析結果

全体の構造

  • 構成は、入力層、BN(バッチ正規化)、残差ブロック35個(3×3畳み込み 512→512)、policy と value の2つのヘッドです。
  • 512本のうち320本は、入力層の BN の γ が 0 です。 生の入力を受け取るのは192本だけで、残りの320本は途中のブロックが計算結果を書き込むための空きチャンネルになっています。
  • ブロック6は重みがすべて0(バイアスのみ)で、実質的に何もしていません。
  • 書き込みの量はブロック0〜11では小さく(ノルム0.2〜0.7)、ブロック12以降で増え、ブロック27・33・34が最大(2.3〜2.9)です。

入力層:生の入力情報を受けるチャンネル

入力カテゴリ 1特徴あたりの重みの大きさ
利き数(自・敵) 3.7〜3.9(最大)
駒の配置 約3.0
利き 約2.7
王手 1.5
持ち駒 約0.5(歩の5枚目以降はほぼ0)

個別の特徴で最も重視されているのは、自玉と敵玉の利き、利き数1以上、歩と香です。代表的なチャンネルは次のとおりです(3×3カーネルは、ほぼ中央の1マスだけに重みがあります)。

  • ch470:自玉
  • ch237:敵玉
  • ch86:自金・と
  • ch418:敵金・成銀
  • ch17:敵の馬・角・竜
  • ch23:敵の竜・飛
  • ch263:自馬
  • ch346:自角・馬
  • ch340:自飛・竜
  • 持ち駒:香→ch12、桂→ch369、銀→ch117、金→ch177、角→ch384・ch441、飛→ch447、王手→ch247

玉と金のチャンネル(ch470、ch237、ch86、ch418)は、多くのブロックが読みに行く中心的なチャンネルです。後段で生まれる重要なチャンネルも、主にこの4本から作られています。

value(局面評価)に効くチャンネル

fc 層の ReLU を無視して線形近似した値です。正の値は手番側の勝率を上げる方向を意味します。

ch 寄与 内容 主に書き込むブロック
329 −43.2 途中で生成。主に自玉・敵玉・敵金・自金の情報から作られます。玉の危険度に相当する特徴だと推測されます 14、15、18
500 +32.5 ほぼ途中で生成。元は自玉・敵玉・自金・自銀です。玉の安全度か、相手玉を攻めている度合いと推測されます 13、8、7
263 +19.2 自馬(敵の香とは逆符号) 33、34、29
328、331、507 +11〜17 途中で生成 中盤〜後半のブロック
166 −15.0 自分の利き数が少ないほど評価が下がる(利きの薄さ) 18、7、17
17 −14.5 敵の馬・角・竜 34、28
375 +12.9 自分の持ち駒の桂 33、34
470 −10.9 自玉 33、32
4 +10.8 敵玉の利き 20、7
23 −9.6 敵の竜・飛 34、1

まとめると、評価は玉の安全度(ch329、ch500)が中心です。そこに、大駒の成り駒(自馬は+、敵の馬・竜は−)と自分の利きの厚み(ch166) が加わっています。盤上のマス別に見た value の感度は、四隅と盤の端が大きくなりました。これはゼロパディングによる影響を含むので、そのまま「隅が重要」とは読まないでください。

policy(指し手)に効くチャンネル

  • ch309 と ch397 は、ほぼすべての移動ラベルで上位に入ります。「何かが動ける」ことを表す汎用のチャンネルです。

  • 成るかどうかで使われるチャンネルが分かれます。不成では ch397 と ch309、成りでは ch317・ch469・ch448 が中心です。

  • 桂の移動では ch224・ch324・ch218 が専用に使われています。

  • 駒打ちは、持ち駒を表すチャンネルと直接つながっています。

    • 打香→ch12、打桂→ch369
    • 打銀→ch368・ch117
    • 打角→ch384、打飛→ch447
    • 打金は上位が ch424・ch40 で、持ち駒の金 ch177 は12位

    なお、打歩は ch174・ch172 で、持ち駒の歩 ch297 は59位と、つながりは弱めです。

  • value の上位30本と policy の上位30本は1本も重なりません。 最後の段階で、評価用と指し手用にチャンネルの役割がはっきり分かれています。

ResNet10x154

LLMの解析結果をそのまま貼る。

ResNet10x154 の解析結果

全体の特徴

  • 使われていない部品がほとんどない:残差ストリーム、中間チャンネル、value のマップに、使われていないものはありません。value の隠れユニットも、使われていないのは1個(93)だけです。
  • 重複した部品もない:同じブロックの中間チャンネルどうしの方向の類似度は最大0.54、value の隠れユニットどうしでも最大0.76でした。
  • 入力層で γ=0 の残差チャンネルが20本ある:ただしブロック0・1が値を書き込むので、層2以降はすべて働いています。
  • ブロック9の書き込みが最大:書き込み量は他の3〜4倍で、出力を最終的に組み立てる役割です。

残差ブロックの役割

ブロック 書き込み量 役割(推定) 無効化すると減る手(倍率) 無効化の影響(policy loss / value の誤差) 書き込みの大きさと相関する局面の特徴
0 0.141 局面の基本情報の組み立て。自分の利きの数を整理する(ch80「利き2以上」、ch23「利きちょうど1つ」)、飛・竜の利き(ch68) 打歩 0.67、上成 0.69 +0.702 / +0.531(policy への影響が9ブロック中最大) 盤上の駒の数 +0.50
1 0.118 入玉の検出(相手の利きのチャンネル ch52 に書き込む) 上成 0.77、打飛 0.78 +0.372 / +0.385 自玉の入玉 +0.36、敵玉の入玉 +0.37
2 0.123 両玉の周りの攻防の評価(敵玉と敵玉の利き ch125 に書き込む) 打金 0.74、打銀 0.78 +0.269 / +0.354 自玉の周りの相手の利き +0.38、敵玉の周りの自分の利き +0.38
3 0.124 両玉の周りの攻防(桂・香を使う攻め。自玉の利き ch37、相手の持ち桂 ch60 に書き込む) 打桂 0.83、打香 0.89 +0.209 / +0.369 自玉の周りの相手の利き +0.31
4 0.131 桂を使った攻防(ch60、ch73、両玉の利き ch62 に書き込む) 打角 0.84(桂左は1.33倍、打飛は1.24倍に増える) +0.289 / +0.437 自玉の周りの相手の利き +0.23
5 0.148 入玉・終盤での玉の位置(自玉 ch85)と相手の飛車(ch126) 打歩 0.70 +0.310 / +0.387(王手のかかった局面の value に大きく影響) 入玉 +0.29〜0.33、盤上の駒の数 −0.27
6 0.157 大駒が下がって成る手(相手の飛・竜の利き ch116、角・馬の利き ch102 に書き込む) 左下成・右下成 0.08 +0.299 / +0.122(value への影響は小さい) 目立った相関なし
7 0.170 駒打ちの種類の選択(自玉の利き ch108・ch117 に書き込む) 打角 0.51、打桂 0.61(打飛は1.48倍に増える) +0.277 / +0.137(value への影響は小さい) 相手の持ち駒の数 +0.21
8 0.190 王手の局面の処理と、横に動いて成る手(自玉の利き ch108・ch14・ch109 に書き込む) 右成 0.06、左成 0.08 +0.472 / +0.598(王手のかかった局面の value への影響が最大) 王手 −0.27
9 0.522 出力の最終組み立て。ブロック8が作った横成りの候補を絞り込む。value が最も強く読む ch79 への書き込みの大部分を担う 上 0.39、左上 0.29(左成・右成は約12倍に増える) +4.028 / +3.418 王手 −0.55
  • 書き込みの強さ:ブロック0〜5は、書き込みを0.9倍に弱めると policy が悪化しました。ブロック6〜9は、policy だけを見ると書き込みが強すぎます(0.9倍で改善)。ただし value はその強さを必要としています(ブロック9を0.9倍にすると value の誤差が +0.218)。
  • 複数のブロックからの重ねた書き込み:ch21・ch50 は、後ろのブロック(6〜9)から重ねて書き込まれています。

残差チャンネル(ブロック間の154本)の主なもの

駒の配置を表すチャンネル(入力層での意味)
ch 入力層での意味 備考
57 自玉 ブロック0・2・3・4・5・9が読む。大きいモデルの ch470 に相当(方向の類似度 0.92)
41 敵玉 ほぼすべてのブロックが読む中心的なチャンネル。大きいモデルの ch237 に相当(0.93)
100 自金・と・成香 大きいモデルの ch86 に相当(0.92)。ブロック9が読む
148 敵金・と・馬 大きいモデルの ch418 に相当(0.93)。ブロック3が読む
12 敵竜・飛 大きいモデルの ch23 に相当(0.94)
107 敵角・馬 大きいモデルの ch17 に相当(0.79)
64 自馬・竜 大きいモデルの ch263 に相当(0.73)
133 自角・馬 大きいモデルの ch346 に相当(0.95)。ブロック7が読む
88 自飛・竜 大きいモデルの ch340 に相当(0.96)。ブロック6・7が読む
20 敵玉の利き 大きいモデルの ch4 に相当(0.72)
82 相手の利き1以上・自飛 ブロック4〜8が読む
98 自分の銀・香・金 ブロック9が読む。policy では左下(−0.54)・桂左(−0.52)を抑える
policy に直接効くチャンネル
ch 入力層での意味 policy での使われ方 補足
0 自分の歩の利き 上 +0.61、上成 +0.38 歩を突く手を支える。大きいモデルの ch220 に相当
58 敵の飛・角・銀・桂・金 上 +0.50、左上 +0.44、右上 +0.42 敵の駒の前に上がる手を押し上げる
15 途中で生成 上 +0.32(上の重みは全チャンネル中4位)、上成 −0.19 銀や金が前の空きマスへ上がれることを表す。ブロック8・9が強く書き込む
136 自分のと・との利き 打角 −0.44、打金 −0.37、打銀 −0.27、打飛 −0.27、打香 −0.15 最終層では「敵玉に隣接する空きマス」で特に強く出る(隣接マス 1.04 / 遠いマス 0.23)。敵玉の隣への駒打ちを抑える向きに働く
123 自分の持ち金がない(自持金1 −0.18) 打金 −1.36 持っていない金を打つ反則手を抑える部品
8 相手の利きなし・敵玉の利き 打銀 +0.42、打金 +0.41、左下成 +0.31 支えのある、敵玉に隣接したマスで強く出る
83 自分の利きあり・相手の歩の利きなし 打銀 +0.56、打金 +0.49、上 +0.35、打歩 +0.29 駒打ちの候補のマスを示す
21 相手の持ち金・自金・敵玉の利き 打歩 +0.17、打銀 +0.13、上成 −0.28、下 −0.26 ブロック6〜8が重ねて書き込む
50 相手の歩が利いていないマス 打桂 −0.30、打飛 −0.26、打金 −0.12、打銀 −0.12 ブロック7・8が書き込む
23 自分の利きがちょうど1つ(入力層) 打歩 +0.32 最終層では、利きの数による値の違いがほぼなく、入力層での意味を失っている
7 相手の歩 打桂 −0.38、打銀 −0.33 ブロック4が書き込む
91 相手の香の利き 打歩 +0.30、打桂 +0.27
112 自分の銀・飛 打歩 −0.62
37 自玉の利き(負) 上成 −0.24、左 −0.22 ブロック3・5が書き込む
11 相手の香・歩の利き 打銀 −0.50、打金 −0.45
72 敵飛・敵飛の利き 打金 −0.40
34、93、135、137 途中で生成 34:上・上成を抑える/93:右上・左を抑える/135:斜めに上がって成る手/137:斜めに下がる手
value に効くチャンネル
ch 入力層での意味 役割
79 敵玉の利き +0.26、自分の利き1以上 +0.22、相手の利き1以上 −0.21 value ヘッドが最も強く読むチャンネル(value_conv1 からの読み込みの重みが全チャンネル中1位)。最終層の合計は駒の点数差(+0.60)・自分の持ち駒の数(+0.40)と相関し、優勢度に相当する。書き込みの大部分はブロック9(平均 +15.5)で、ブロック0は負(−4.4)に書き込む
3、7、11 3:利きの数の差/7:相手の歩/11:相手の香・歩の利き value_conv1 からの読み込みが強い(平均の1.7〜2.0倍)

中間チャンネル(各ブロックの conv1 出力)で役割が特定できたもの

ブロック・中間ch 読む残差ch 書き込む先と効果 役割
b7 中間ch104 相手の歩の利き(ch120)、相手の利き(ch63)、敵玉の利き(ch43)、自玉の利き(ch96)をいずれも負で読む。周りに利きの少ない、静かなマスで働く 自玉の利き(ch96)+1.28、飛・竜の利き(ch149)+1.25、ch27 +1.13、ch142 +1.05 ほか。policy への合計効果は、左下成 −2.05、右上成 −1.95、左上成 −1.86、桂右成 −1.54、左 −1.45 静かな空きマスで成る手を抑える部品。両玉入玉の局面ではこの抑えが強すぎ、無効化すると両玉入玉の局面で policy が確かに改善する(基準の最善手への log 確率 +0.010 / +0.023)。入玉のない局面への影響はほぼ0
b9 中間ch139 敵玉の利き(ch67)を負で読む。相手の駒(ch41、ch58)を正で読む ch24 −3.20、ch77 +2.66、ch51 +2.55 ほか(主に駒打ちの経路)。ch79 にはわずかに負(−0.18) 持ち駒を持って攻めている状態に反応(攻めとの相関 +0.30、自分の持ち駒の数との相関 +0.36)。主な役割は駒打ち
b9 中間ch62、ch131 — ch79 に正(+0.29、+0.17) 攻めに反応する(相関 +0.26〜0.34)。ただし攻めだけに反応するわけではない
  • 一度も働かない中間チャンネル:0本です(1540本のうち)。
  • 単独で無効化しても影響が小さいもの:43本(floodgate 系で、KL と value の誤差の変化がどちらも0.0005未満)。
  • 探索での最善手との一致で見ると:無効化の候補311本のうち227本で policy が確かに悪化しました。ほぼすべての中間チャンネルが役に立っています。

value ヘッド

value_conv1 の出力マップ(27枚)
マップ 役割
24 自玉が敵陣にいることの目印。敵陣3段の合計は、自玉が入玉していると中央値18.1、入玉していないと3.5(95%点 9.7)。1〜2段目に絞るとより分かれる(13.8 / 1.7)。自玉の位置との相関 0.526
21 敵玉が自陣にいることの目印。自陣3段の合計は、入玉していると18.2、入玉していないと1.8(8〜9段目に絞ると 13.5 / 0.9)
15 盤上の駒の数(局面の段階)。駒の数との相関 0.739(合計の平均は、駒26枚未満で10.3、39枚以上で33.6)。敵玉の位置とも相関(0.487)
18 自玉の位置(相関 0.418)
6 敵玉の位置(相関 0.355)。9段目に絞ると敵玉の入玉の目印になる
20、14 王手がかかると小さくなる(王手 8.3 / 王手なし 19.4)
12 駒の損得に反応する隠れユニットが主に読むマップ
value_fc1 の隠れユニット(154個)
ユニット 役割
25、9、104、141、27、50、142、137、41、66、74、7(value_fc2 が負) 駒の点数差に反応(駒の点数差との相関 −0.62〜−0.71、相手の持ち駒の数との相関 +0.43〜+0.56)。入玉局面では入玉なしの2〜5倍強く働き、評価を大差に振りすぎる原因になる
29、72、71、2、68、135、79、61、122、118、51、116(value_fc2 が正) 上と同じく、入玉局面で強く働き、評価を振りすぎる側に寄与する
131、96、44、24、134、43、81、31、98、76、17、69(value_fc2 が正) 攻めの評価。自分の持ち駒の数(相関 +0.33〜+0.50)と敵玉の周りの自分の利き(+0.23〜+0.43)に反応。入玉局面や攻めていない局面でも同じように働く
146、42、93 使われていない(value_fc2 の重みが約 1e−40)。93は一度も働かない
その他 154個のうち103個は、1個だけ無効化しても value の誤差の変化が0.001未満
  • 線形近似の精度:value ヘッドを ReLU を無視して線形化した評価値は、実際の評価値と相関 0.983 です(z = 3 ↔ 近似値 約7.0)。

ネットワークパラメータの書き換え

上記の解析結果を基にネットワークパラメータの書き換えを行った。

書き換え内容は以下の通り。

rikiyat.github.io

Sparks of Weight-Space Programming: LLMs can natively read & write neural network weights

We find that frontier LLMs are surprisingly good at natively reading and writing neural network weights, using a variety of recent tools and algorithms or even via direct weight editing.

https://blog.jj1guj.net/posts/bme280_with_xiao_esp32c6/

BME280をXiao ESP32C6で使う方法

今までRaspberry Pi 3A+にBME280をつなげて寝室の気温・湿度・気圧を測定していた1が、足を引っかけて壊してしまったので足を引っかけないように小型化することにした。 その際にBME280搭載の温湿度センサをXiao ESP32C6から使えるようにする方法を備忘録として残しておく。

使用部品

使用した部品は以下の通り。

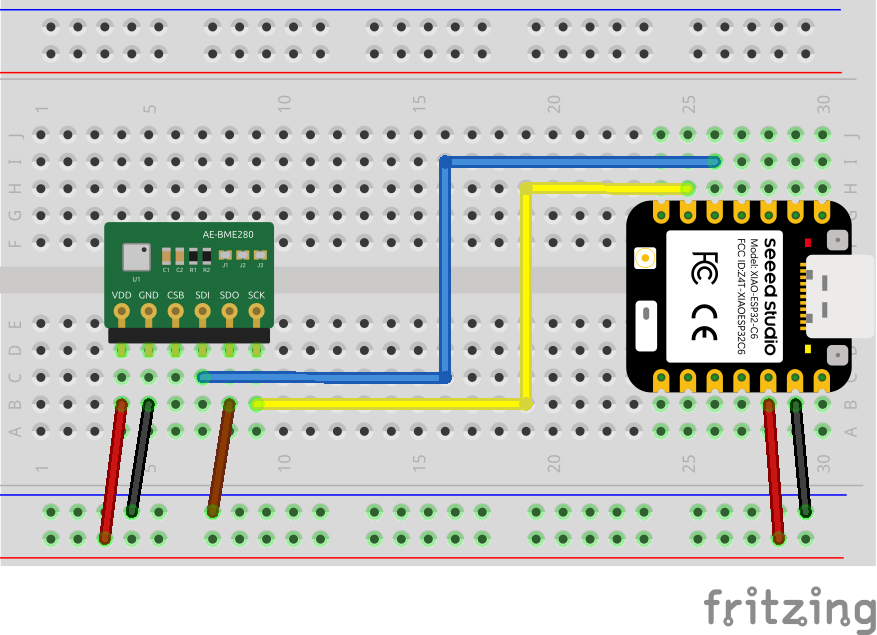
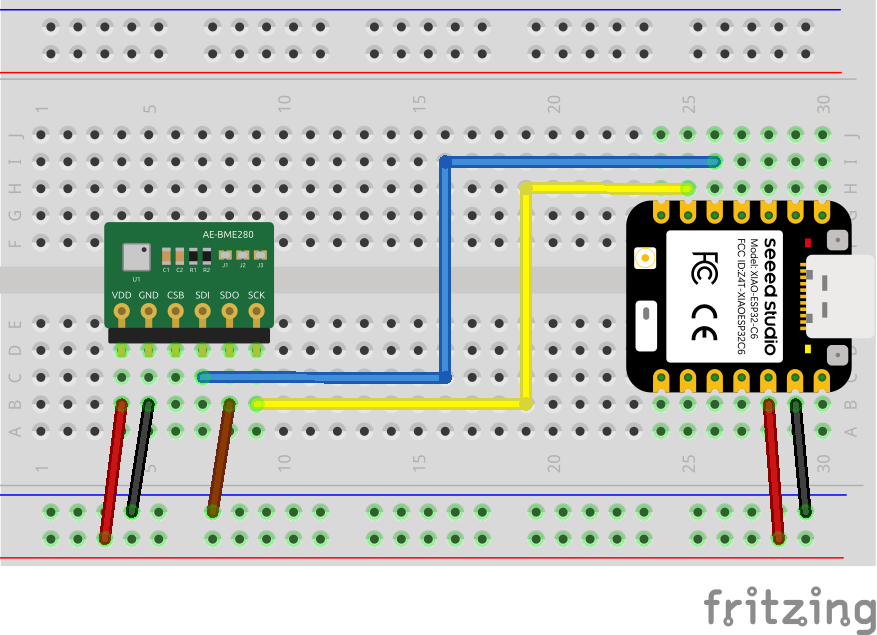
配線図

配線図は以下の通り

配線図

配線図

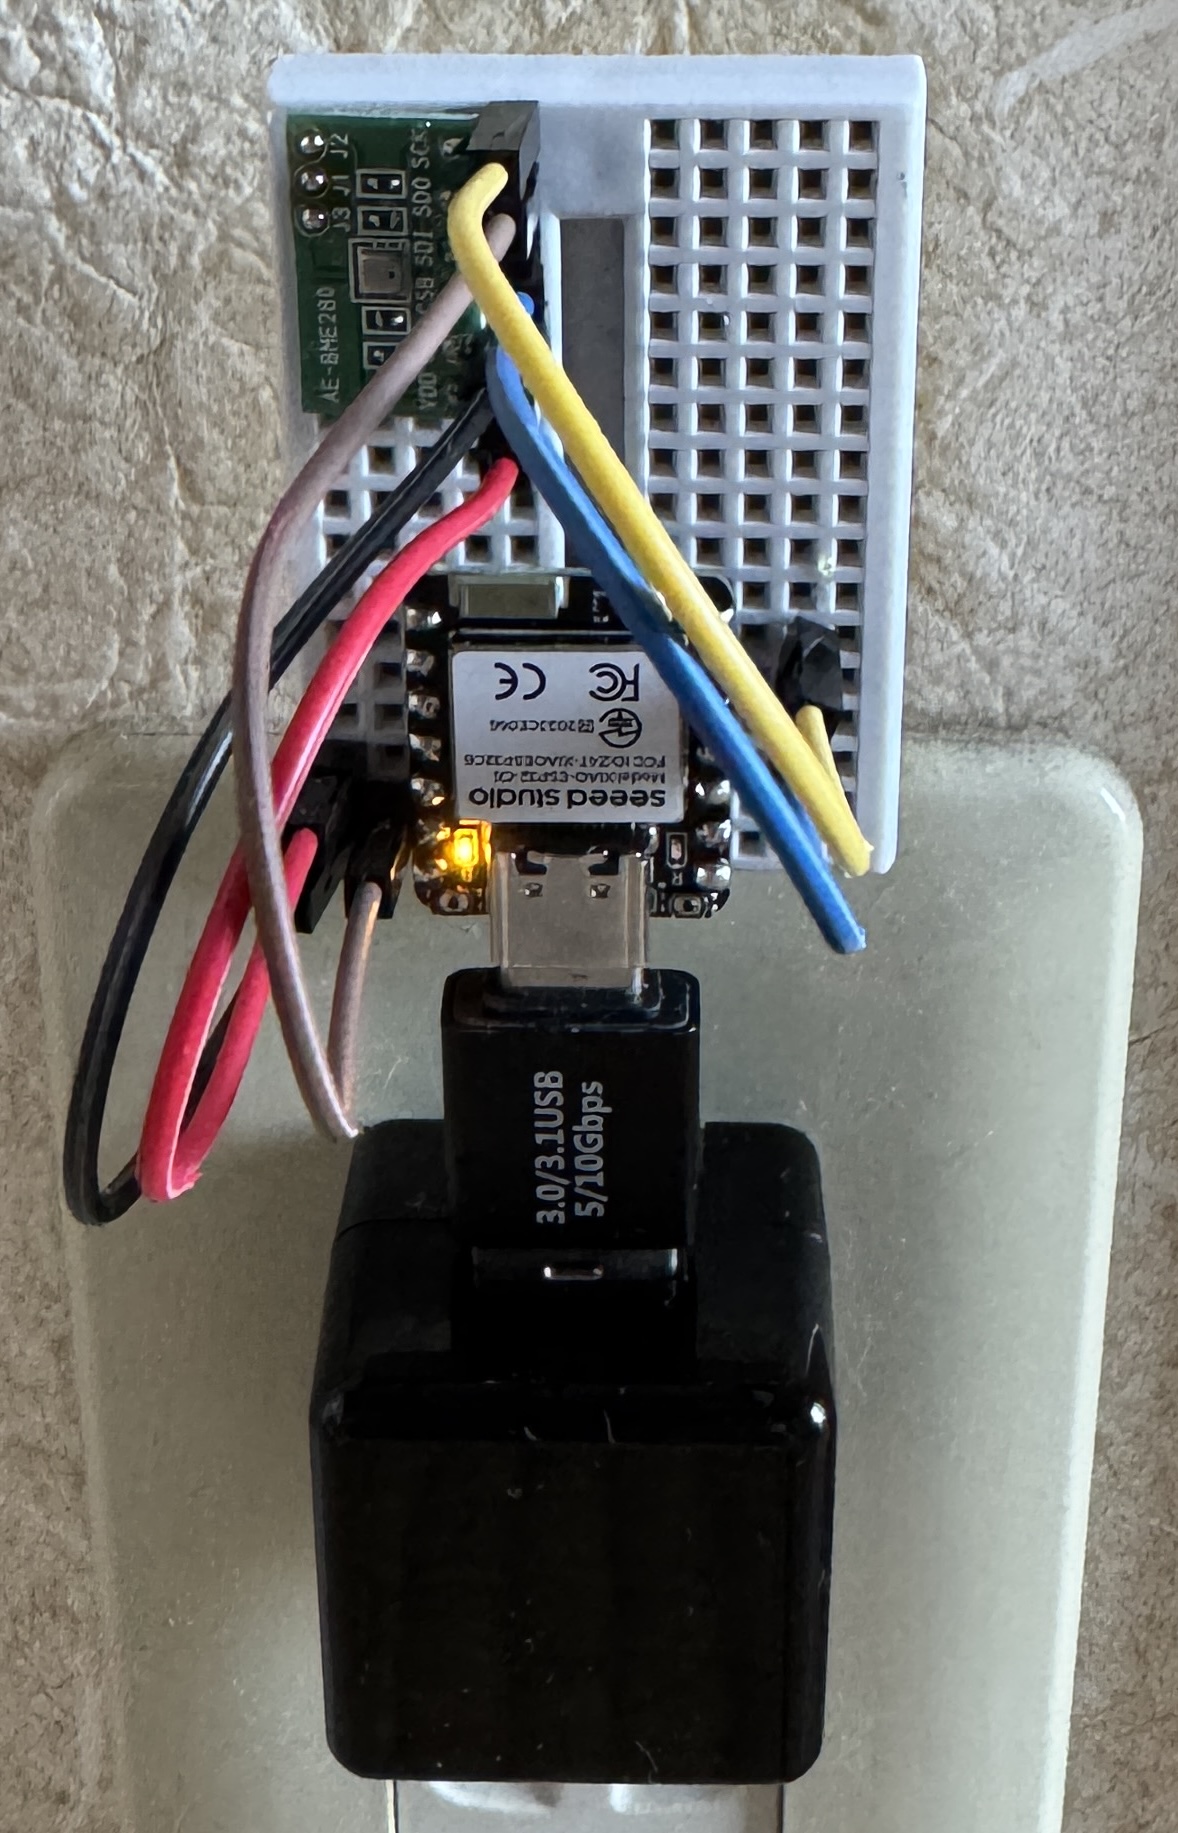
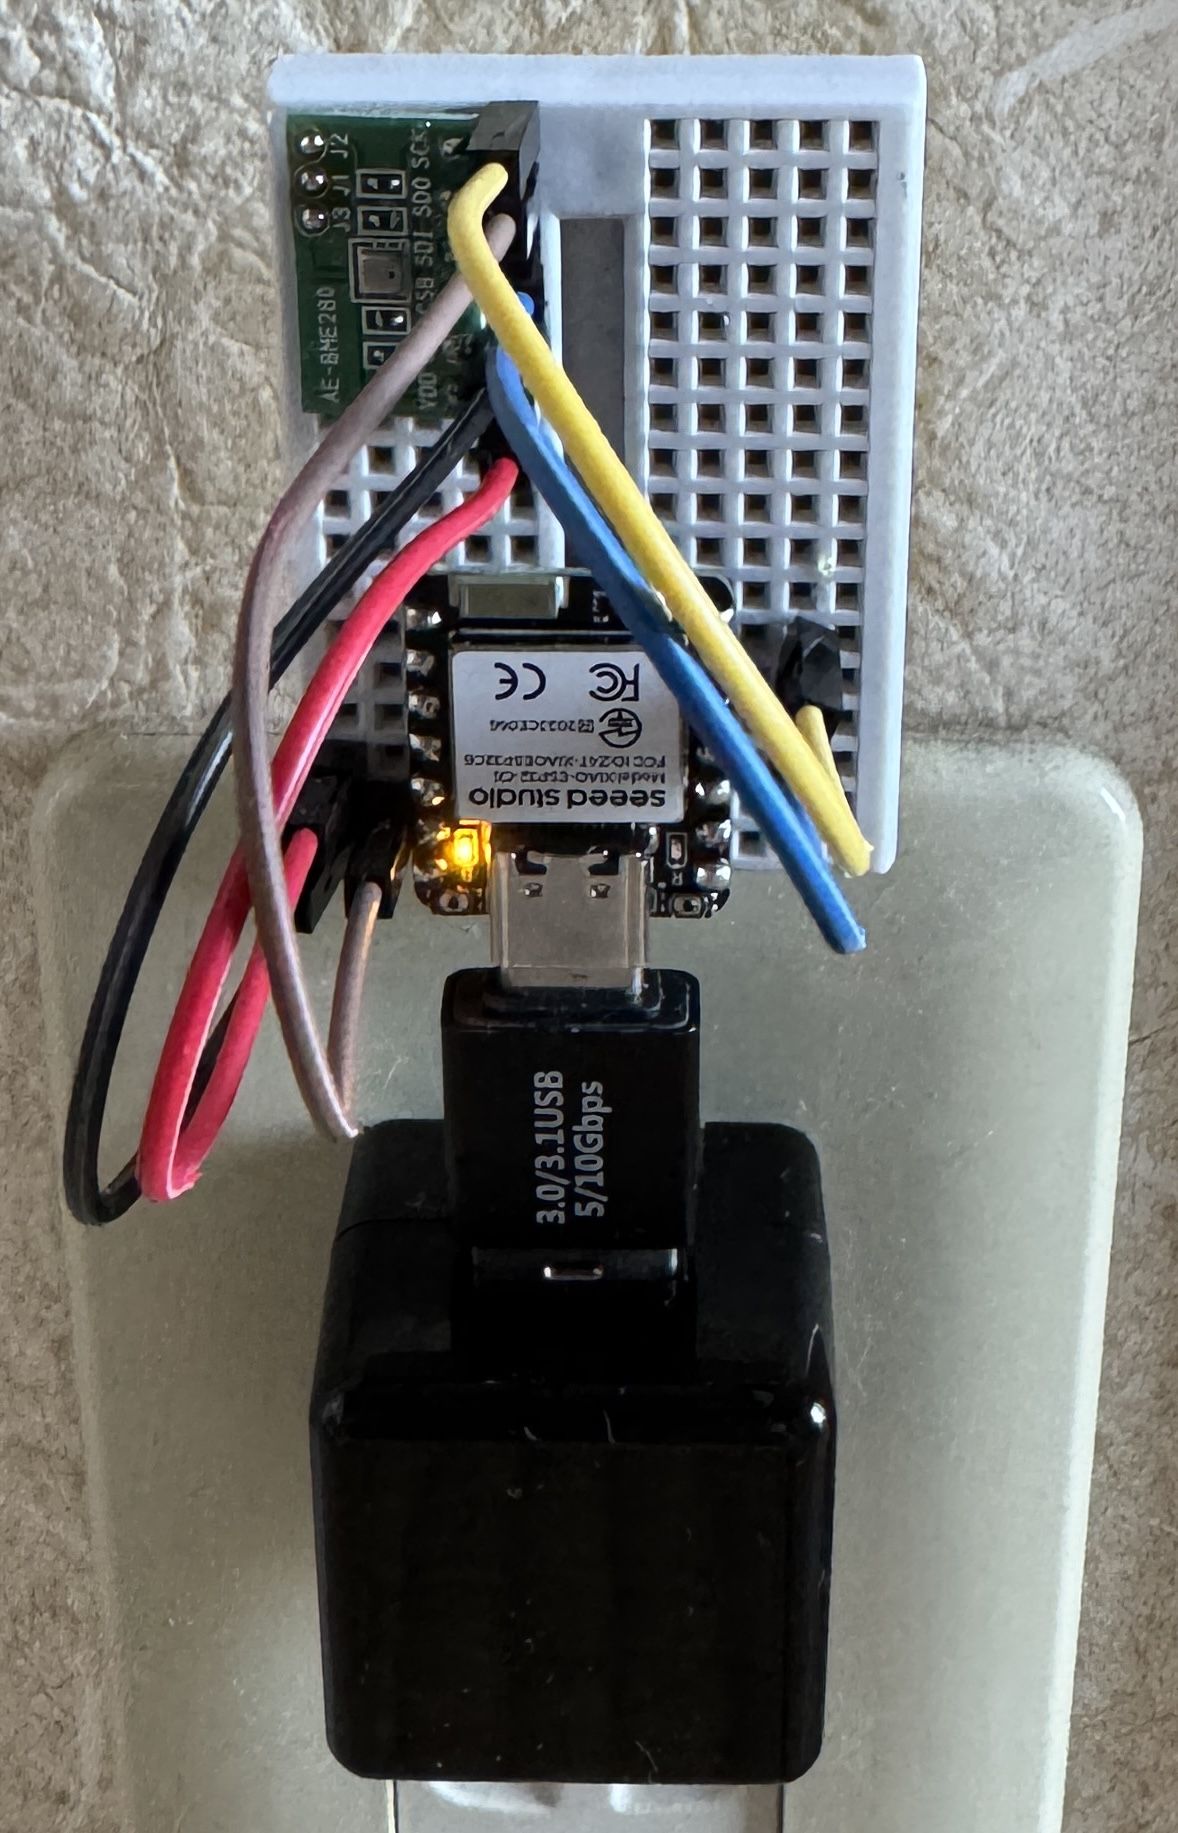
最終的にXIAO ESP32C6のUSB Type-CポートにUSB ACアダプターを挿してコンセント経由で常時給電させた。 このときに使用した追加の部品は以下の通り。

画像の説明

完成図

コード

コードは以下の通り

#include <Wire.h>
#include <Adafruit_BME280.h>

Adafruit_BME280 bme;

void setup() {
  Serial.begin(115200);
  Wire.begin(22, 23);
  if (!bme.begin(0x76, &Wire)) {
    Serial.println("BME280 is not found!!");
    while(1) delay(10);
  }
}

void loop() {
  float temp = bme.readTemperature();
  float hum = bme.readHumidity();
  float press = bme.readPressure() / 100.0;
  Serial.printf("%.2f C, %.2f %%, %.2f hPa\n", temp, hum, press);
  delay(2000);
}

最終的にこのようにWiFi機能と組みあせて気温・湿度・気圧をJSONで返すWebサーバーを実装した。

https://github.com/jj1guj/room_metrics_prometheus/blob/master/server/bme280_server/bme280_server.ino

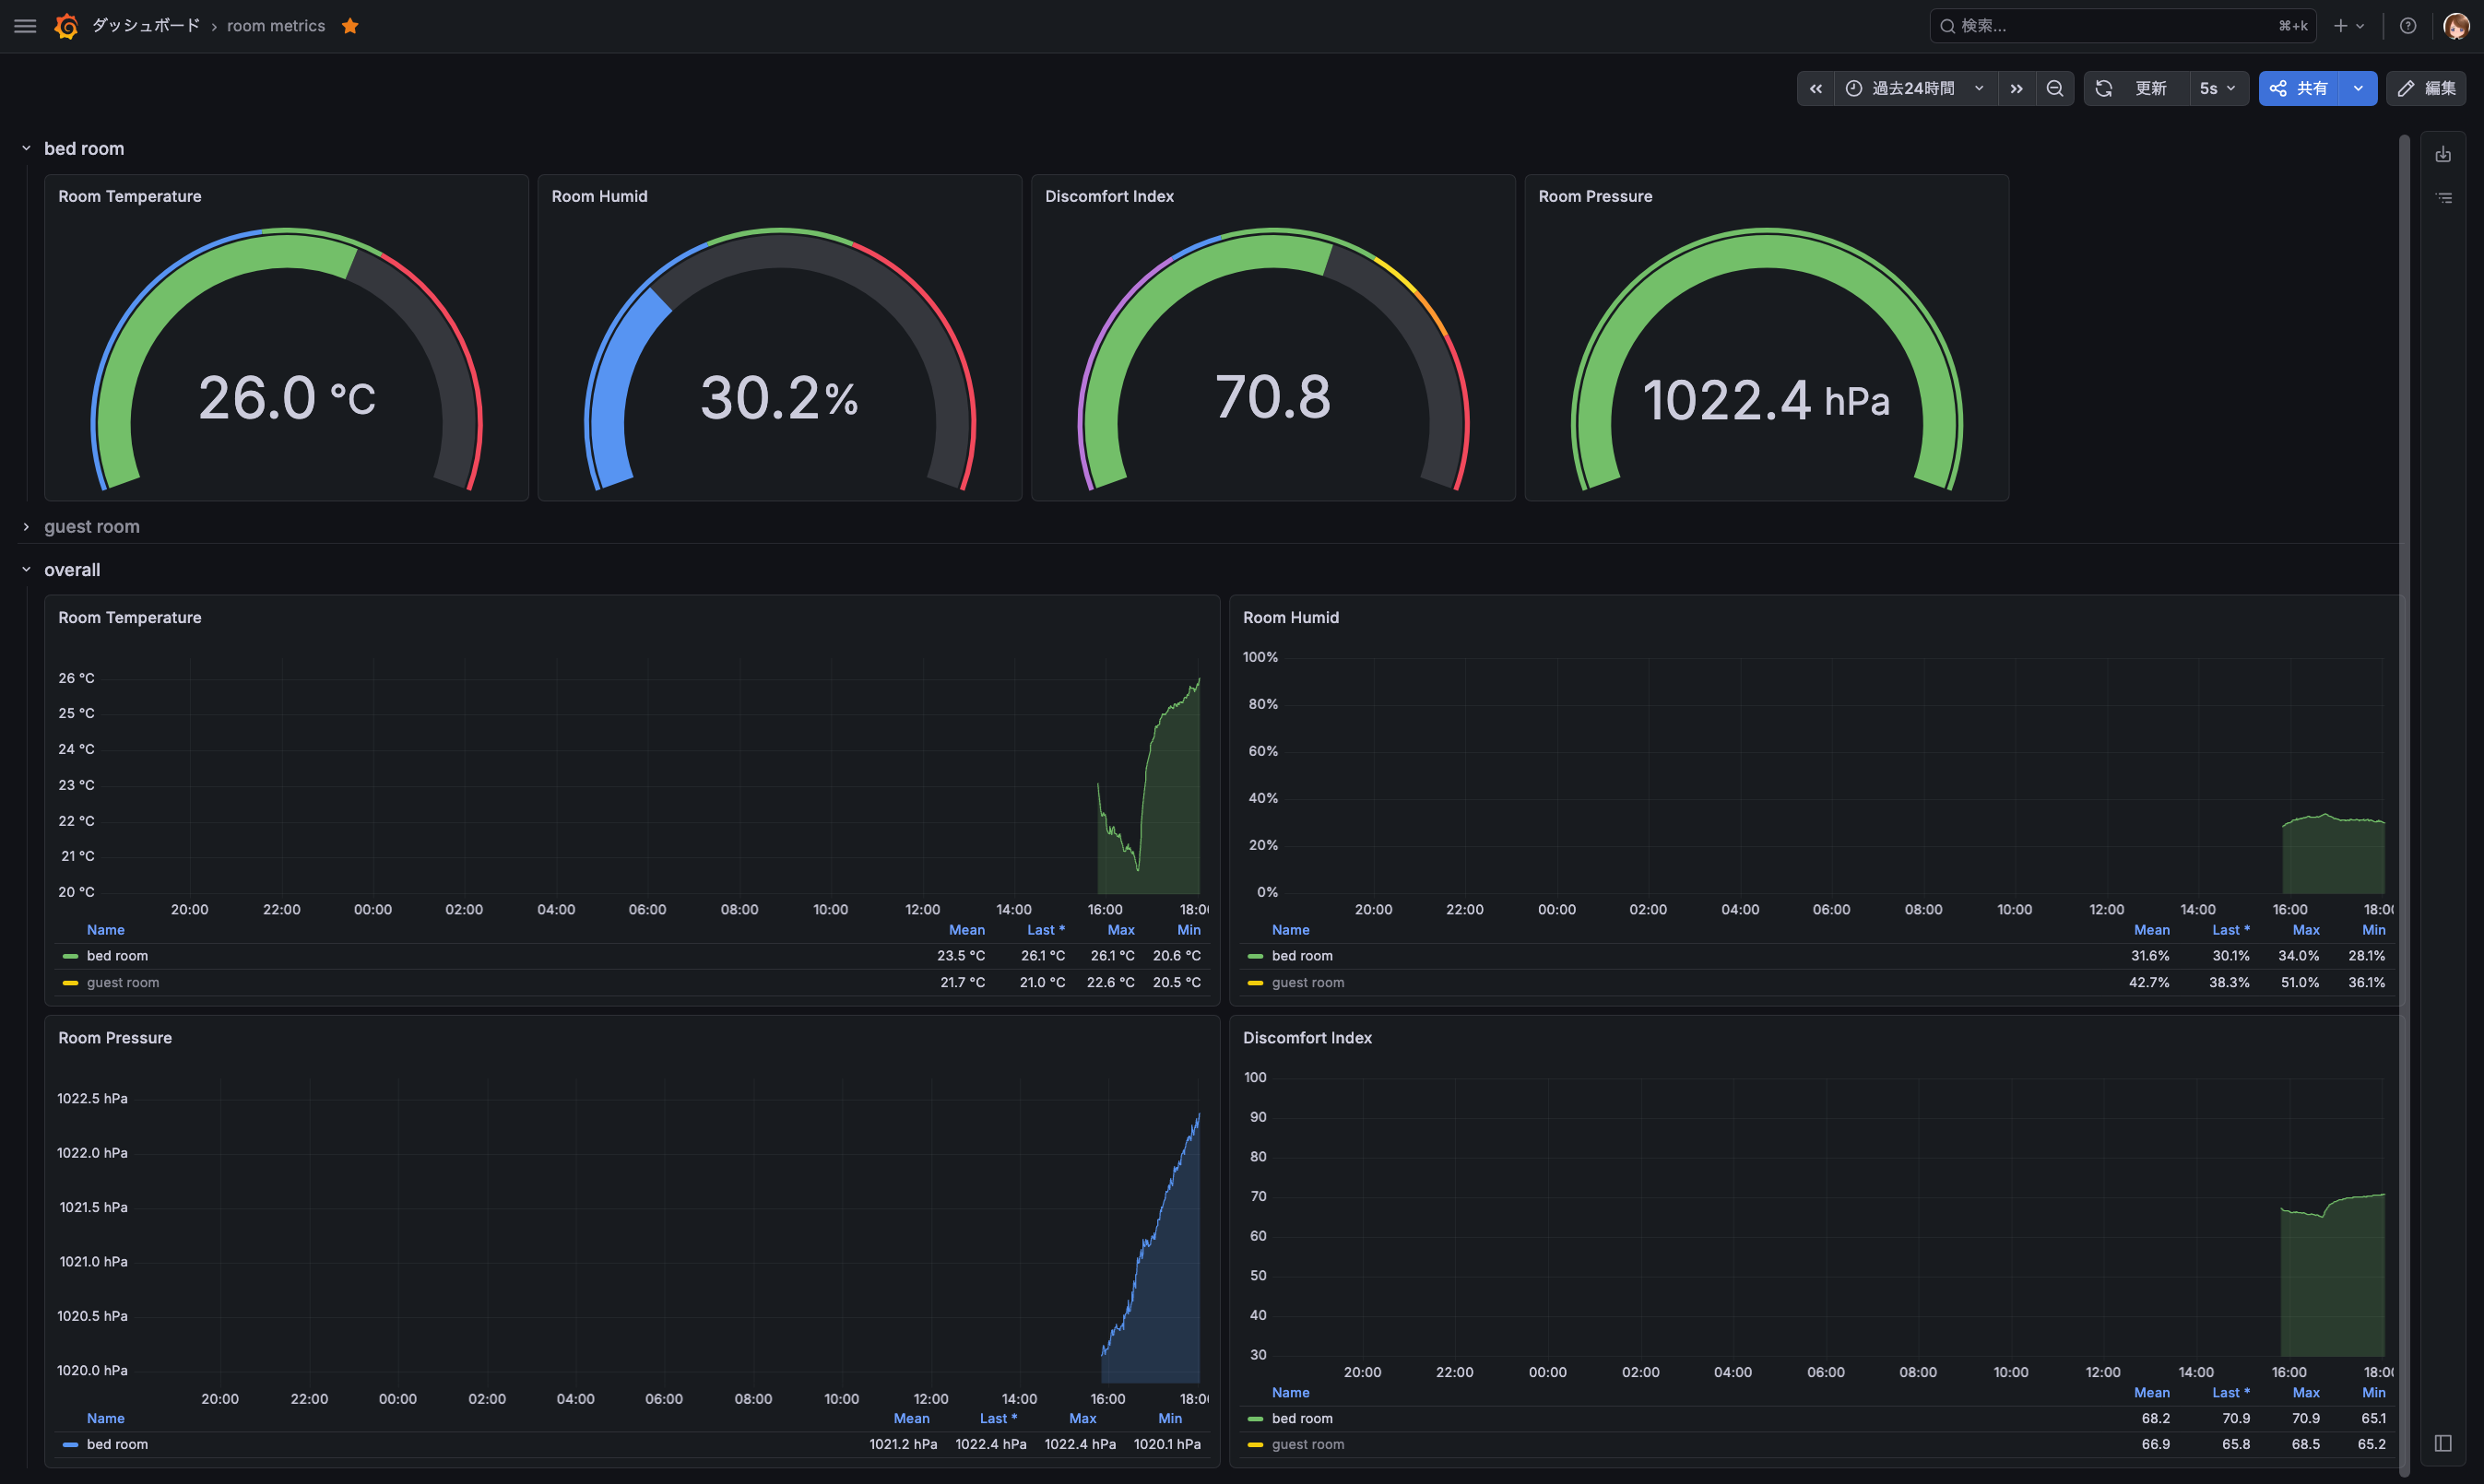
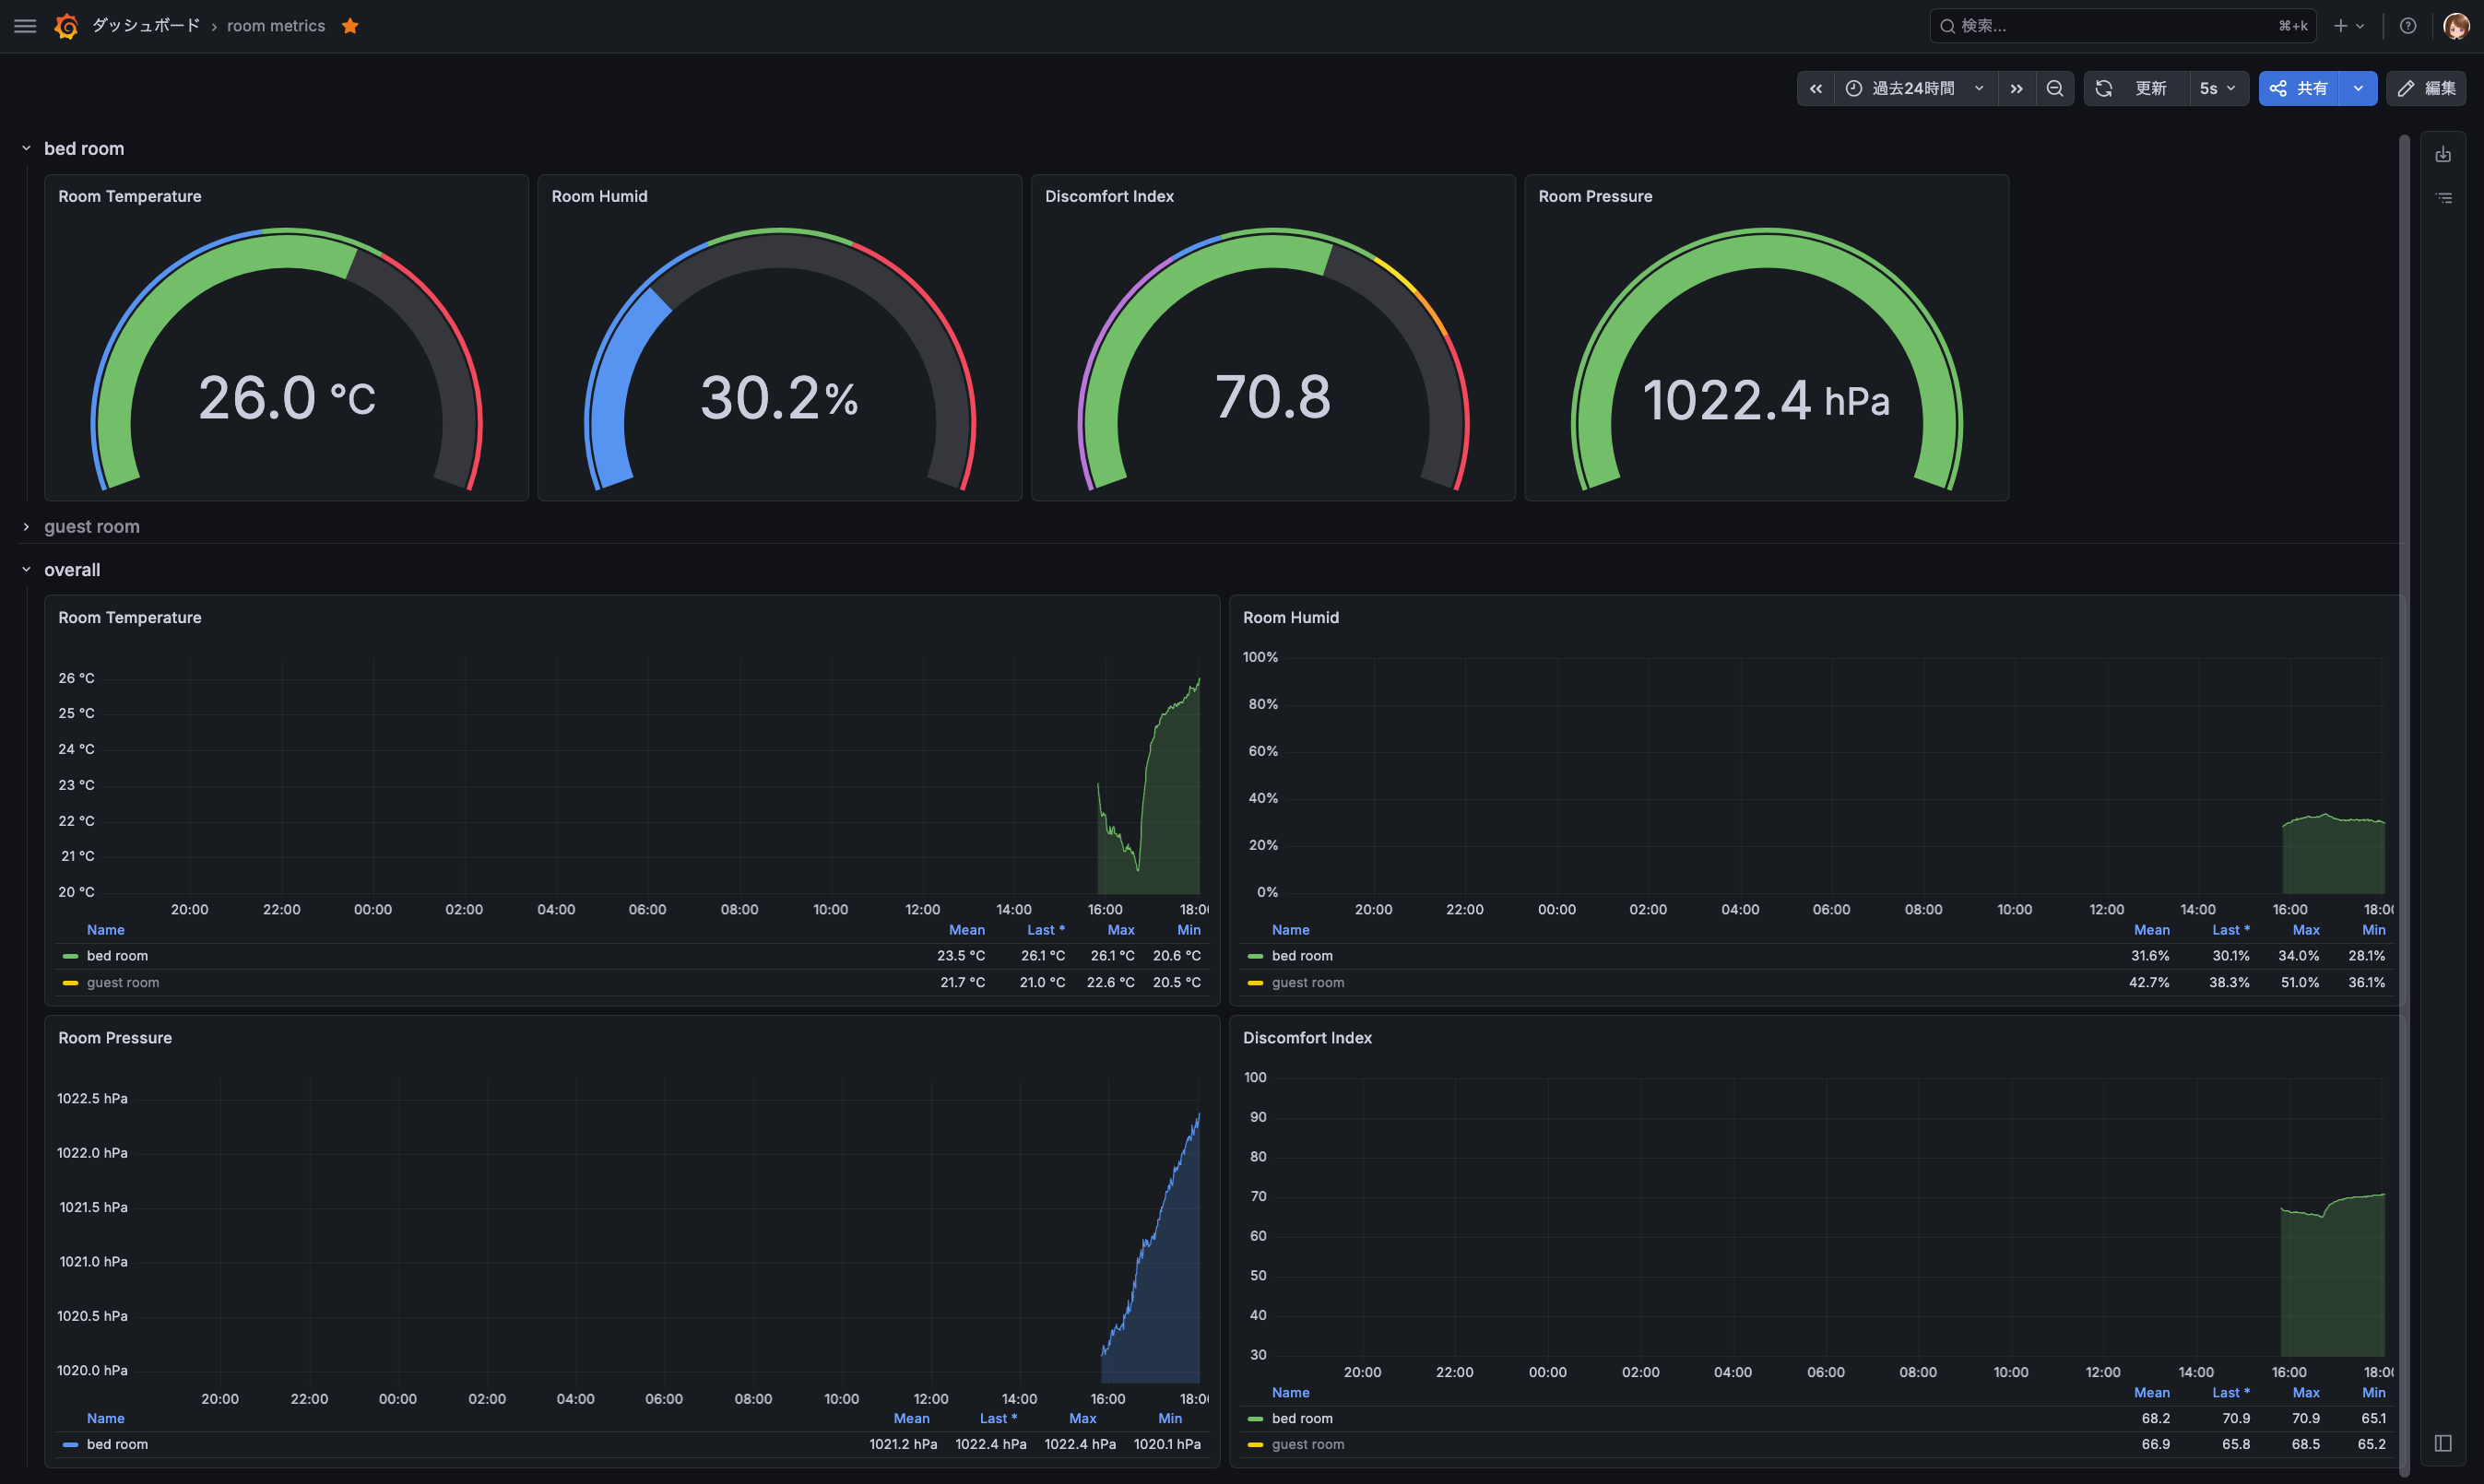
これを一定時間ごとにfetchしてPrometheusに送信するスクリプトを書いてGrafanaで表示できるようにしている。

https://github.com/jj1guj/room_metrics_prometheus/blob/master/client/main.py

Grafanaのメトリクス画面

Grafanaのメトリクス画面

感想

久しぶりにはんだ付けをしたらめちゃくちゃ下手になってて泣いた。 定期的にはんだ付けをするべき

ライブラリを使うと時短になってとてもよい。


  1. しかもGrafanaをデプロイしているサーバーからリモートGPIOを叩いて取得するとかいう訳のわからない方法をとっていて本当にめちゃくちゃでメンテナンス性最悪だった ↩︎

配線図
ALT text

配線図

画像の説明
ALT text

画像の説明

Grafanaのメトリクス画面
ALT text

Grafanaのメトリクス画面

https://blog.jj1guj.net/posts/introduction-of-my-blog/

JJ1GUJのブログの紹介

今回は備忘録としてこのブログについての解説記事を書いていきます。

きっかけ

自宅サーバーでMisskeyを始めたり他にも様々なWebアプリをホスティングしていく中で、 次第に外部サービスにデータを預けたくないなと思い始めたのがきっかけです。1
特にZennが出始めたころ、何も考えずにQiitaからZennに乗り換えたら、いつまでも自分のブログを作らないままかもしれないと思っていました。 プラットフォームを乗り換えるくらいなら、自分でブログを運営しようと考えていました。 また、普段からMisskeyを通じてFediverseを楽しんでいたので、作るならFediverseにもつながるブログにしたいと思いました。 そこで、必要な機能を整理し、それを実現できる仕組みを探すところから始めました。

開発の流れ

開発は以下の流れで行いました。

  1. 要件定義・技術選定
    • Claudeと壁打ちをして方針を固める
  2. 実装・動作確認
    • 実装はGitHub Copilotに丸投げ、人間は動作確認をしてフィードバックをする
  3. デプロイ

要件

Claudeと壁打ち・技術選定をする中で決めた要件は次の通りです

docker composeで動かすようにする

Misskey開発や業務でメンテナンスの大変さを体感していたため、メンテナンス性を意識する上でなるべく自前のプログラムは減らしたいという思いがありました。 そのため、なるべく既存のOSSの公開されているイメージを活用し、コマンドを1回叩くだけで開発/本番環境が立ち上がるようにすることを要件に加えました。 これの副次的効果として開発・運用時にホストの環境を汚さず、環境構築の手間を大幅に省くことができました。

記事ごとにディレクトリを作れるようにする

記事と画像などを別々の場所に保存すると、対応関係が分からなくなったり、探す手間が増えたりします。 そのため、記事ごとにディレクトリを作り、記事とメディアを一緒に保存できることを要件にしました。

記事はMarkdownで書けるようにする

軽いメモを取るときでもMarkdownで書いてしまうくらいMarkdownに飼い慣らされてしまったのでこれは必須だと考えていました。 直近で自分のHPもMarkdownで書けるようにしたらものすごく快適になったからというのもあります。

記事はFediverseにも配信する

Fediverse上のメジャーなプラットフォームであるMastodonやMisskeyはどちらも(マイクロ/ミニ)ブログサービスを提供するためのプラットフォーム基盤と謳っています。

Mastodon

Your self-hosted, globally interconnected microblogging community

Misskey

Misskeyはオープンソースの分散型マイクロブログプラットフォームプロジェクトです。

加えて分散型SNSユーザー有志のホームページでは以下のように接続できるプラットフォームの例としてマイクロブログ・ブログを最初に挙げています。

マイクロブログ、ブログ、フォトブログ、ビデオホスティングなどの多様なプラットフォームが接続されています。

であるならばブログをFediverseに配信するのは当然でしょう。

記事に対するFediverse上での反応(いいね・ブースト/リノート・リアクション・リプライ・引用)はすべて記事上から見れるようにする

自分がなぜここまでMisskeyにハマっているのかを考えたときに真っ先に浮かんだのがいろんな人から多様なリアクションを受け取れることでした。 そのため、Fediverseにブログ記事を配信する際にこの楽しみが失われてしまっては勿体ないと考え、要件に加えました。 記事に反応がたくさんついているとちゃんと読まれているんだなと感じ、承認欲求が満たされて精神衛生上とてもよいです。

技術選定

WordPress+ActivityPubプラグイン

この要件を満たすことができるOSSがないかClaudeに聞いたところ、WordPress+ActivityPubプラグインをおすすめされました。 しかしphp2shellでPHPを使っているサービスが軒並みメンテナンスに入って大変なことになっているのを見ていたこと、PHPは脆弱性の数でアピールしていることから自宅でホスティングしてメンテナンスしていくのはかなりきついだろうと思い採用を見送りました。

WriteFreely

つぎにおすすめされたのがWriteFreelyでした。

https://writefreely.org

これひとつでFediverseとの連携が可能でかなり魅力的に思えたのですが以下の点から採用を見送りました。

Hugo+GoToSocial+GoatCounter

次におすすめされたのがHugo+GoToSocial+GoatCounterの構成でした。

https://gohugo.io

https://gotosocial.org

https://www.goatcounter.com

これは実際にClaudeに実装させてローカルでの動作環境を試してみました。 しかし試しているうちに公開されているリアクションを読み取るだけでも認証が必要になり、サーバー側で認証をしアクションを中継する常駐プログラムが必要になることから採用を見送りました。

Madblog

これを踏まえてブログとFediverseサーバーが一体化したOSSを使った方がいいのではとなり、Claudeに調査させたところMadblogが見つかりました。

https://github.com/blacklight/madblog

実際に使って試してみたのですが、以下の点から採用を見送りました。

  • 記事とメディアデータの保存先のディレクトリが異なる

    • メディアデータについては/img直下にサブディレクトリを作成できない
  • x64向けイメージしか配布していない

    • Raspberry Piなどでホスティングしたくなったときにイメージをビルドしなくてはならず、手間が増える
  • 数式を表示できるようにするためにフルでイメージをビルドするとイメージサイズが2GBを超える

    Includes all plugins - including LaTeX and Mermaid; > 2 GB in size.

  • バックエンドがPython

    • 個人的にバックエンドがPythonのWebアプリはなるべく動かしたくないという思いがあった(個人の感想)

最終的な構成

最終的にHugoで記事ごとにディレクトリを作成できるなど執筆体験が非常によかったため、以下のようなHugo+Hollo+GoatCounterの構成にしました。

https://docs.hollo.social/

Hugo+GoToSocial+GoatCounterの構成とかなり似ていますが、投稿・リプライ数・フォロワー数を認証無しで読み取ることができ、中継するための常駐プログラムが不要であるからHolloを採用しました。

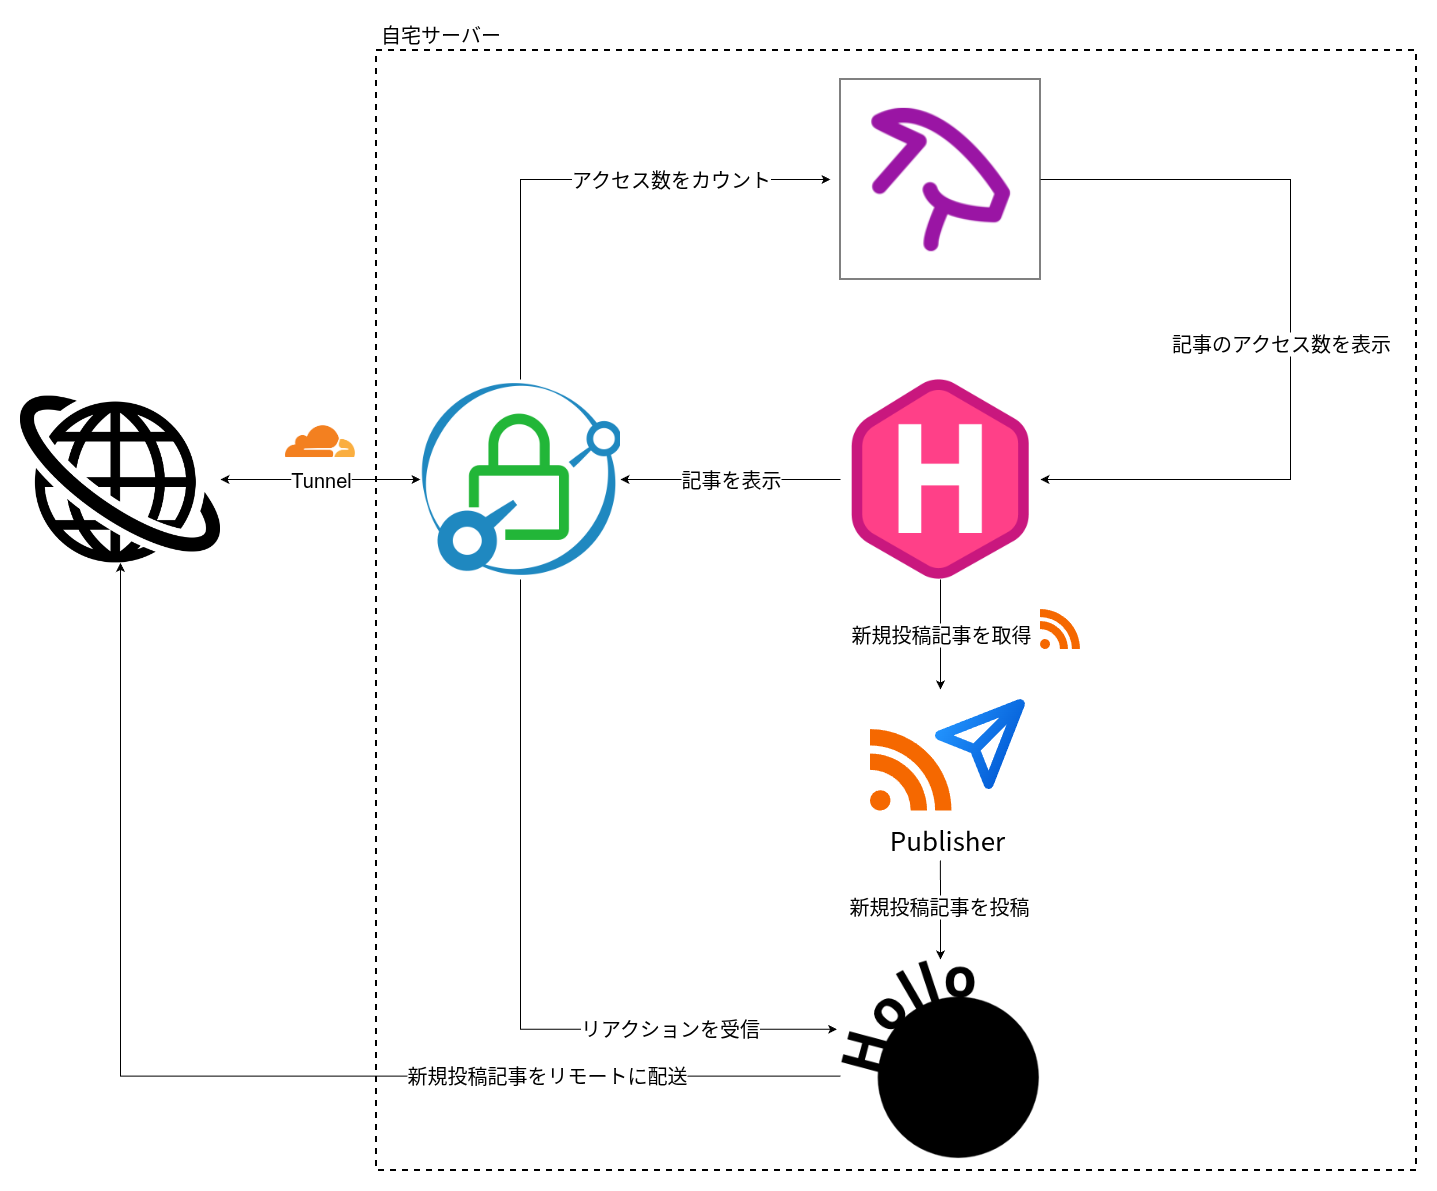
システム構成図

システム構成図

それぞれの役割はこのようになっています。

  • Caddy: Hugoが生成したページを配信し、連合や計測の要求をHollo・GoatCounterに転送する
  • Hugo: ブログ本体
  • Publisher: RSSから新しい記事を見つけ、Holloに投稿する
  • Hollo: 新規投稿記事のリモートへの配送とリアクションの受信を行う
  • GoatCounter: ブログ記事の閲覧数を取得する

ブログのページでは、HolloとGoatCounterから反応や閲覧数を取得し表示しています。 返信や引用は、Holloが取得できる範囲のものを表示しています。

工夫した点

工夫した点として初回の管理者作成画面は公開側からのアクセスを遮断し、外部に公開しない管理用ポートから設定するようにした点があります。

Holloは初回起動直後にページにアクセスし、アカウントを作成する必要があります。 しかしこれをCloudflare Tunnelで公開した状態でその公開URLにアクセスし、アカウント作成を行おうとすると悪意のある第三者が先にアクセスしてアカウントを作成してしまう懸念がありました。 そのため、Holloの初回の管理画面には外部には公開しない管理用ポートからしかアクセスできないようにすることでこの問題を解決しました。 普段Holloの管理画面に入ることはほとんどないのでこの機能により安心感は増したのですが、いざ管理画面に入りたくなったときに管理用ポートを開くのが面倒でもうすこしいい方法がなかったかなと思っています。

今後の展望

今後以下の機能・ページを実装したいと考えています。

  • aboutページの追加
  • フォロワー一覧を表示できるように
  • 各記事から前のエントリと次のエントリに飛べるように

Fediverseの連携機能は現状満足していますが見た目の作り込みはまだ甘いと感じています。 そのため、フロントエンドの強化を今後頑張る予定です。

最後に

今回作成したブログシステムはGitHub上で公開しているのでぜひ使ってみてください。

今後もいろんな記事を投稿する予定なので以下のハンドルをフォローしたり記事にリアクションやリプライをくださると嬉しいです!

@blog


  1. といいながらGoogleに年間1.5万円くらい払ってデータを全部預けるGoogleの犬をやっている ↩︎

blog.jj1guj.net

JJ1GUJのブログの紹介

このブログの構成を紹介します

https://blog.jj1guj.net/posts/my-first-post/

初投稿

こんにちは、JJ1GUJです。

普段はMisskeyに生息しています。

https://jiskey.dev/@jj1guj

そろそろ自前のブログシステムがほしいな、と思いClaudeとGitHub Copilotをしばき倒して作ってみました。

Fediverse連携の部分をかなりこだわっていて、Fediverse上でリアクションしたり、ブーストしたり、返信・引用をするとそれがブログ記事の方にも反映されるようになっています。

よかったらリアクションとかしてくれるとうれしいです!

このブログシステムがどんな構成をしているかは次回あたりに備忘録的に書こうと思います。

これから積極的にいろんな記事を投稿していきたい

jiskey.dev

JJ1GUJ/2 :sabakan: 🚓️🐾️ (@jj1guj)

[jiskey](https://jiskey.dev)のかんりしゃで幼稚園児 駆け出しブラウザ屋さん 普段は将棋AI作ったりオセロAI作ったりしてる Misskeyサーバーなんもわからん プロセカおじさん ヘッダ画像はJPEG XRです 第33回世界コンピュータ将棋選手権11位 第34回世界コンピュータ将棋選手権13位 第35回世界コンピュータ将棋選手権10位 第36回世界コンピュータ将棋選手権5位